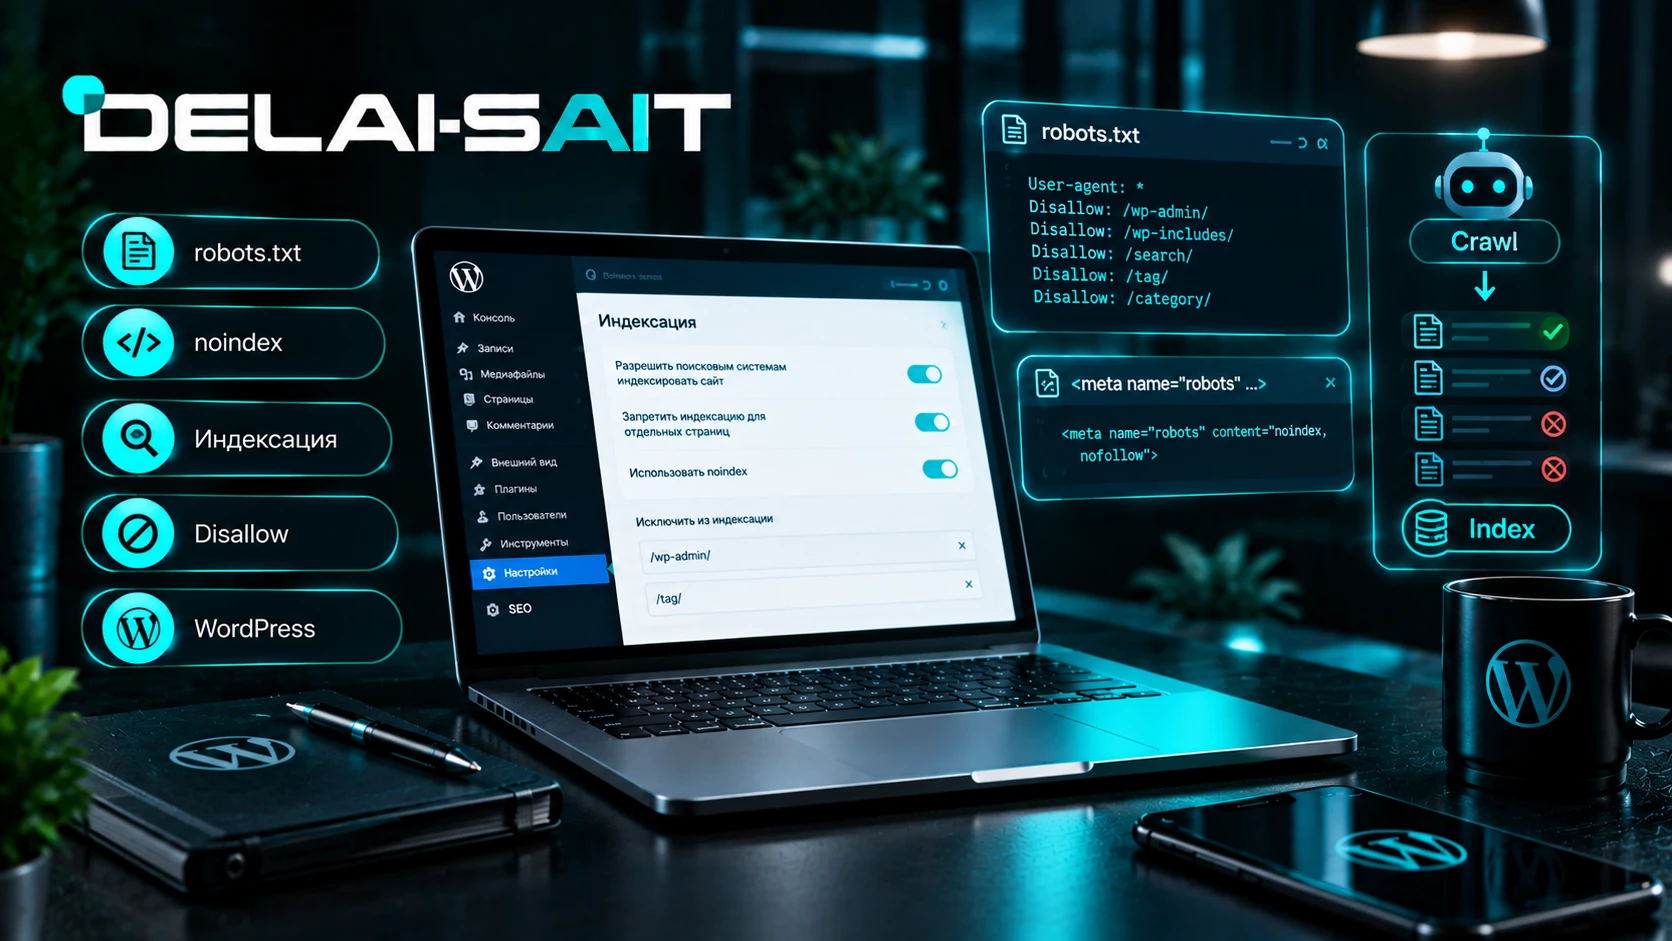
Кратко: robots.txt — это текстовый файл в корне сайта, который разрешает или запрещает поисковым роботам обходить те или иные адреса. Директива noindex — это метатег на конкретной странице, который просит поисковик не показывать её в результатах. Это два разных инструмента: robots.txt управляет обходом (crawl), noindex управляет индексацией. Главное правило новичка — никогда не закрывать в robots.txt то, что вы исключаете через noindex: если робот не сможет прочитать страницу, он не увидит и метатег. В WordPress robots.txt генерируется автоматически, поэтому его удобно править фильтром robots_txt, а noindex добавляют хуком wp_robots — для поиска, пагинации, архивов и служебных страниц. Ниже — синтаксис директив, готовые сниппеты на PHP, скрипт проверки на JavaScript, сравнительная таблица и разбор типичных ошибок.
Что такое robots.txt и зачем он нужен сайту
robots.txt — это обычный текстовый файл, который лежит в корне сайта по адресу https://вашсайт.ру/robots.txt. Поисковые роботы первым делом запрашивают его и читают правила: какие разделы можно обходить, а какие трогать не нужно. Это не команда, а вежливая просьба, которую соблюдают все крупные поисковики — Яндекс, Google и другие. Злоумышленник или парсер правила проигнорирует, поэтому robots.txt — инструмент для поисковых роботов, а не защита от взлома.
Зачем вообще что-то закрывать? Причин три. Первая — технический мусор: страницы поиска, корзины, результаты фильтров, служебные адреса. Их не нужно тратить драгоценный лимит обхода, ведь робот тратит на них время, а пользы для выдачи ноль. Вторая — дубли: один и тот же контент доступен по нескольким адресам, и поисковику нужно помочь выбрать главный. Третья — нагрузка: если разрешить обход бесконечных календарей и параметров, робот может «застрять» и нагружать сервер тысячи раз в сутки.
Важно понимать разницу между «не обходить» и «не показывать». robots.txt говорит роботу, куда не ходить. Если адрес закрыт в robots.txt, робот не увидит содержимое страницы — но при этом иногда всё равно покажет её в выдаче, взяв заголовок из внешних ссылок. Чтобы страница гарантированно не попала в результаты поиска, нужен не robots.txt, а метатег noindex. Об этом различии мы подробно поговорим ниже — это самая частая точка ошибок у новичков.
Для WordPress есть отдельная особенность: файла robots.txt на диске обычно нет. Ядро отдаёт его «на лету», генерируя содержимое на PHP. Поэтому не получится просто открыть файл на FTP и отредактировать — правильный путь лежит через фильтр, встроенный в WordPress.
Синтаксис robots.txt: директивы, которые нужно знать
Формат файла простой: каждая строка — это директива, а имя директивы отделяется от значения двоеточием. Регистр в именах директив не важен, а комментарии начинаются с символа решётки. Ниже — рабочий пример, в котором собраны все директивы, которые реально нужны на обычном сайте на WordPress.
# robots.txt для сайта на WordPress

User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Disallow: /search
Disallow: /*?s=
Disallow: /*&preview=
Disallow: /?add-to-cart=

User-agent: Yandex
Disallow: /cart/
Disallow: /checkout/
Clean-param: utm_source&utm_medium&utm_campaign

Sitemap: https://delai-sait.ru/sitemap_index.xml
Разберём ключевые директивы. User-agent задаёт, к какому роботу относятся следующие за ним правила. Звёздочка означает «все роботы», а строка User-agent: Yandex открывает отдельный блок только для Яндекса. Disallow запрещает обход, а Allow разрешает его — при конфликте правил побеждает более длинное совпадение, поэтому Allow: /wp-admin/admin-ajax.php перекрывает общий запрет на /wp-admin/.
Отдельно стоит сказать про Clean-param — директиву Яндекса, которая склеивает адреса с разными UTM-метками в один. Это спасает от дублей, когда рекламные ссылки добавляют к странице хвосты вида ?utm_source=vk. Директива Sitemap указывает на карту сайта, и её удобно оставить поисковикам как подсказку. Больше о карте сайта и её настройке — в отдельной статье про XML-карту сайта (sitemap) для Яндекса и Google.
Ещё одна директива, которую часто ищут новички, — Host. Раньше она помогала Яндексу выбрать главное зеркало, но сейчас устарела и в новых файлах не нужна: главное зеркало подтверждается в Яндекс Вебмастере. Символ звёздочки в путях тоже нужно использовать осторожно: маска Disallow: /*?* закроет вообще все адреса с параметрами, включая полезные, а не только мусорные.
И маленькая, но важная деталь: файл должен лежать строго в корне и быть доступен по HTTPS без редиректов. Если робот получит ошибку или переадресацию, он может вообще проигнорировать ваши правила.
robots.txt в WordPress: виртуальный файл и фильтр robots_txt
Поскольку WordPress отдаёт robots.txt динамически, редактировать его нужно кодом. Для этого ядро предусмотрело фильтр robots_txt, который передаёт готовый текст файла в вашу функцию. Небольшое предупреждение: не добавляйте бесполезные строки, если правила уже сгенерированы правильно, — лучше дописывать только то, чего не хватает. Ниже — сниппет, который закрывает текстовый файл целиком и формирует своё содержимое.
<?php
/**
 * Полностью берём robots.txt под контроль.
 * Код можно добавить в functions.php дочерней темы или в свой плагин.
 */
add_filter( 'robots_txt', 'ds_custom_robots_txt', 20 );

function ds_custom_robots_txt( $output ) {
    $lines = array(
        'User-agent: *',
        'Disallow: /wp-admin/',
        'Allow: /wp-admin/admin-ajax.php',
        'Disallow: /search',
        'Disallow: /*?s=',
        'Disallow: /?add-to-cart=',
        '',
        'Sitemap: ' . home_url( '/sitemap_index.xml' ),
    );

    // Каждую строку завершаем переводом строки.
    return implode( "\n", $lines ) . "\n";
}
Хук robots_txt — это классический пример работы фильтров: ваша функция получает текущее значение и возвращает изменённое. Если хотите не заменять файл целиком, а лишь дополнить сгенерированный вариант, просто верните $output . "\nDisallow: /new-path/". Всю механику фильтров и экшенов мы разбирали в статье про хуки actions и filters в WordPress.
Есть и второй, более простой путь — вообще не трогать код, а включить генерацию robots.txt в SEO-плагине. Rank Math и Yoast умеют собирать файл из настроек с живым редактором прямо в админке: вы видите текстовое поле, редактируете его и сохраняете. Для сайта без собственного кода это часто удобнее и безопаснее, чем сниппет. Как включить редактор robots.txt в популярных плагинах, показано в разборе про настройку SEO-плагина Rank Math и Yoast.
Небольшая практическая деталь: изменения в виртуальном robots.txt вступают в силу сразу, но поисковик подхватит их не мгновенно — он перечитывает файл раз в несколько часов или суток. Если вы закрыли мусорный раздел, не ждите, что страницы исчезнут из выдачи в ту же минуту.
Директива noindex и её отличие от Disallow
noindex — это метатег в HTML-коде страницы, который говорит роботу: «страницу можно прочитать, но в результатах поиска не показывай». Самый простой вариант выглядит так:
<meta name="robots" content="noindex, follow">Тег добавляется в раздел <head> страницы. Атрибут follow означает, что робот может не показывать страницу в выдаче, но по ссылкам с неё ходить разрешено, и вес он передаёт дальше. Если поставить nofollow, ссылки с этой страницы тоже перестанут учитываться. Для большинства служебных страниц лучше noindex, follow: страниц не видно в выдаче, но внутренняя перелинковка не рушится.
Теперь главное отличие. Директива Disallow в robots.txt и метатег noindex работают на разных этапах и заменять одно другим нельзя. Если адрес закрыт в robots.txt, робот не скачает страницу и никогда не прочитает её метатеги — включая noindex. Поэтому правило звучит однозначно: чтобы убрать страницу из индекса, используйте noindex и не закрывайте её при этом в robots.txt.
Есть и третья, менее известная форма noindex — HTTP-заголовок X-Robots-Tag. Его применяют для файлов и данных, где нельзя вставить HTML-метатег: PDF, изображения, документы и ответы сервера. В WordPress такой заголовок удобно отдавать через модуль mod_headers на уровне сервера, а в коде — фильтром на отправляемые заголовки. Для обычных HTML-страниц этот способ избыточен, там достаточно метатега.
И ещё один частый вопрос: работает ли noindex для уже проиндексированных страниц? Да, но не мгновенно. Робот должен снова посетить страницу, увидеть метатег и исключить её из индекса. Ускорить это можно, переобойдя URL в панели вебмастера. Быстрее, чем ждать, но всё равно не за одну минуту.
robots.txt, noindex, canonical и nofollow: сравнительная таблица
Новички часто путают четыре инструмента, которые внешне решают «одну задачу». На самом деле у каждого своя роль, и путаница приводит к ошибкам, из-за которых из индекса пропадают нужные страницы. Разложим их по полочкам.
| Инструмент | Что делает | Где задаётся | Когда использовать |
|---|---|---|---|
Disallow (robots.txt) | Запрещает обход страницы | Файл robots.txt | Технический мусор, служебные разделы, мешающие обходу |
noindex | Запрещает показ страницы в выдаче | Метатег или HTTP-заголовок | Уже проиндексированные страницы, которые нужно вывести из поиска |
canonical | Указывает главный адрес среди дублей | Метатег <link> | Один контент доступен по нескольким URL |
nofollow | Запрещает учитывать ссылки | Метатег или атрибут rel | Ссылки, за которые сайт не отвечает |
Как читать эту таблицу на практике. Если мусорная страница ещё не в индексе, а обход её только тратит лимит — хватит Disallow. Если страница уже в поиске, но показывать её не нужно — ставьте noindex и уберите её из robots.txt. Если один товар открывается по нескольким адресам с фильтрами — этим занимается canonical, а не robots.txt. А nofollow сегодня чаще применяют точечно, к отдельным внешним ссылкам, а не ко всей странице целиком.
Есть и правило сочетания: не нужно скармливать роботу противоречивые сигналы. Классическая ошибка — закрыть раздел в robots.txt и одновременно поставить там noindex. Робот страницу не скачает, метатег не увидит и, если страница уже в индексе, может оставить её там. Второе противоречие — Disallow на важный раздел для robots при одновременном noindex: Google в такой ситуации медленнее исключает адрес из индекса, чем если бы он мог прочитать тег.
Как добавить noindex в WordPress: рабочие способы с кодом
В WordPress есть удобный хук wp_robots, который собирает содержимое метатега robots. Это правильный инструмент: не нужно вручную вставлять теги в header.php и следить за дублированием. Хук принимает массив директив, и достаточно вернуть его с нужными ключами. Ниже — пример, который ставит noindex на страницы поиска, архивов даты и результатов пагинации.
<?php
/**
 * Управляем метатегом robots через хук wp_robots.
 */
add_filter( 'wp_robots', 'ds_custom_wp_robots' );

function ds_custom_wp_robots( $robots ) {
    // Страницы поиска.
    if ( is_search() ) {
        $robots['noindex'] = true;
        $robots['follow']  = true;
    }

    // Пагинация: клиентские запросы вида ?paged=2 и /page/2.
    if ( is_paged() ) {
        $robots['noindex'] = true;
        $robots['follow']  = true;
    }

    // Архивы по датам (убирают тонкие страницы из индекса).
    if ( is_date() ) {
        $robots['noindex'] = true;
        $robots['follow']  = true;
    }

    return $robots;
}
Обратите внимание: массив работает как переключатель. Установив $robots['noindex'] = true, вы добавляете директиву, а $robots['index'] при этом лучше снять — иначе метатег получится противоречивым. Хук вызывается только на фронтенде и гарантирует, что тег попадёт в <head> каждого подходящего шаблона, включая кастомные.
Второй способ — точечный noindex для конкретных рубрик или страниц. Предположим, вы не хотите показывать в поиске тонкий раздел с метками, но хотите сохранить их для навигации. Тогда ID рубрики подставляется в условие:
<?php
/**
 * Закрываем от индексации одну служебную рубрику и метки.
 * 12 — пример ID рубрики, которую не нужно показывать в поиске.
 */
add_filter( 'wp_robots', 'ds_noindex_category' );

function ds_noindex_category( $robots ) {
    if ( is_category( 12 ) || is_tag() ) {
        $robots['noindex'] = true;
        $robots['follow']  = true;
    }

    return $robots;
}
Третий способ — подключить noindex на уровне SEO-плагина. В карточке записи, рубрики, страницы или архива Rank Math и Yoast дают переключатель «Advanced» → «Robots Meta», где ставится галочка noindex для выбранного типа. Это удобно, когда редактор сам решает, прятать ли конкретную страницу от поиска. Четвёртый способ — вывод тега вручную в header.php дочерней темы по условию, но он нужен редко: без дочерней темы правки снимутся при обновлении. Если вы ещё не сделали дочернюю тему, поможет гайд про дочернюю тему WordPress, а базовые приёмы и сниппеты собраны в подборке про полезные сниппеты для functions.php.
Что закрывать в WordPress: типовой robots.txt и правила noindex
Понимая инструменты, легко собрать рабочую схему. Она состоит из двух частей: то, что закрываем в robots.txt (обход), и то, что помечаем noindex (индексация). Начнём с robots.txt — ниже готовый вариант для типового сайта на WordPress.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /search
Disallow: /*?s=
Disallow: /*&preview=
Disallow: /?add-to-cart=
Disallow: /*?orderby=
Disallow: /*?filter_
Disallow: /feed/
Disallow: /trackback/

Sitemap: https://delai-sait.ru/sitemap_index.xml
Этот набор закрывает то, что роботу обходить бесполезно: панель администратора (кроме admin-ajax), страницы внутреннего поиска, предпросмотр, корзину, сортировку каталога, бесконечные фильтры и RSS-ленты. Важно не перестараться: CSS- и JS-файлы закрывать нельзя, иначе робот не сможет корректно оценить отображение страницы и решит, что она неудобна на мобильных.
Что не стоит закрывать в robots.txt: сами статьи и страницы, разделы категорий, изображения и служебные файлы темы, которые нужны для рендеринга. Если сомневаетесь, правило простое — если страница нужна для показа в поиске или для передачи веса, она должна быть открыта для обхода.
Теперь про noindex. Лучше всего пометить тегом те страницы, которые должны существовать на сайте, но быть невидимыми в поиске: страницы благодарности после заказа, внутренние тестовые страницы, страницы с тонким контентом, архивы по датам, страницы авторов с одной записью, а также результаты поиска и пагинацию. Для интернет-магазинов это ещё и страницы корзины и оформления заказа. Про то, как устроены адреса и перелинковка в WordPress, подробно рассказано в статье про настройку ЧПУ и постоянных ссылок.
И важное замечание про дубли. Если у вас есть кастомные типы записей и таксономии, у них могут появляться адреса-дубли — например, архив термина и страница категории с тем же контентом. Прежде чем закрывать такие страницы, проверьте, не создаёт ли их ваш код. О правильном построении архивов читайте в разборе про кастомные типы записей и таксономии. А если сайт отдаёт данные через API, стоит убедиться, что служебные эндпоинты не попадают в выдачу — механика описана в статье про REST API WordPress.
Частые ошибки при настройке robots.txt и noindex
Даже опытные разработчики иногда закрывают лишнее. Вот список ошибок, которые чаще всего приводят к выпадению сайта из поиска.
- Закрыт важный раздел целиком. Строка
Disallow: /илиDisallow: /*закрывает весь сайт от обхода. Проверьте файл целиком, а не только свои строки. - noindex и Disallow вместе. Самый частый конфликт: робот не скачает страницу и не увидит метатег, и адрес останется в индексе дольше, чем должен.
- noindex на ключевой странице. Иногда галочку в SEO-плагине ставят у всего раздела и забывают снять с главной или коммерческой страницы. Регулярно проверяйте важные URL в вебмастере.
- Закрытие CSS и JS. Робот должен уметь отрисовать страницу. Закрытые стили и скрипты портят оценку удобства и могут ухудшить позиции.
- Маска
/*?*бездумно. Она закрывает все адреса с параметрами, включая полезные функции, которые используют GET-параметры. - noindex вместо nofollow и наоборот. Директива без
followрубит передачу веса по ссылкам. Для большинства страниц нужен именноnoindex, follow. - Робots.txt закрыт паролем или отдаёт редирект. Если файл недоступен, робот считает, что правил нет, и обходит всё подряд. Проверьте доступность по HTTPS.
- Забыли про карту сайта. Закрытые в robots.txt адреса всё равно попадают в sitemap и сбивают робота с толку. Следите, чтобы два инструмента не противоречили друг другу.
Отдельно стоит сказать про производительность и кэш. Если вы правите robots.txt или метатеги, не забудьте сбросить кэш страниц и плагины кэширования: некоторые отдают старый HTML и ваши изменения «не видны» роботу. О том, как это устроено, читайте в статье про кэширование WordPress. И держите в голове, что любые правки в functions.php удобнее тестировать на дочерней теме или на локальной копии — подробнее об этом в материале про 10 настроек безопасности WordPress.
Как проверить robots.txt и noindex: чек-лист и скрипт на JavaScript
Настроили — проверьте. Ручной чек-лист занимает пару минут: откройте https://вашсайт.ру/robots.txt и убедитесь, что файл отдаётся с кодом 200 и виден как текст; затем откройте пару важных страниц и посмотрите в исходном коде, нет ли у них noindex; наконец, проверьте в Яндекс Вебмастере и Google Search Console раздел «Диагностика» или «Проверка URL».
Чтобы делать это быстрее и сразу по множеству адресов, удобно написать небольшой скрипт на JavaScript и запустить его в Node.js. Он скачает robots.txt, а затем проверит, в каком статусе индексации находятся ключевые страницы.
// check-robots.mjs — быстрая проверка robots.txt и метатегов
const SITE = 'https://delai-sait.ru';
const PAGES = ['/', '/blog/', '/uslugi/'];

// 1. Читаем robots.txt и ищем строки, закрывающие весь сайт.
const robots = await (await fetch(SITE + '/robots.txt')).text();
console.log('robots.txt получен, строк:', robots.split('\n').length);
if (/Disallow:\s*\/\s*$/m.test(robots)) {
    console.log('ВНИМАНИЕ: сайт закрыт от обхода целиком!');
}

// 2. Проверяем метатег robots на важных страницах.
for (const path of PAGES) {
    const html = await (await fetch(SITE + path)).text();
    const meta = (html.match(/<meta name="robots" content="([^"]+)">/i) || [])[1] || '(нет)';
    const bad = /noindex/i.test(meta);
    console.log(path, '→', meta, bad ? '❌ закрыт от индекса!' : '✅ открыт');
}
Такой скрипт можно запускать вручную после правок или встроить в процесс выкладки. Он ловит две самые опасные ошибки: полный запрет обхода в robots.txt и случайный noindex на важной странице. Для регулярного контроля добавьте проверку в мониторинг — тогда проблема не застанет врасплох. Похожие технические задачи автоматизации разбираются в статье про REST API WordPress, если нужно проверять данные прямо из админки.
Частые вопросы о robots.txt и noindex в WordPress
Чем robots.txt отличается от noindex?
robots.txt управляет обходом: он говорит роботу, какие адреса не скачивать. noindex — это метатег на самой странице, который просит не показывать её в результатах поиска. Если страница закрыта в robots.txt, робот не скачает её и не увидит noindex. Поэтому нельзя одновременно закрывать адрес в robots.txt и ставить на него noindex — эти сигналы противоречат друг другу.
Как создать robots.txt в WordPress, если файла нет?
WordPress генерирует robots.txt динамически, поэтому файла на диске обычно нет. Добавьте своё содержимое фильтром robots_txt: ваша функция получит текст файла и вернёт изменённый вариант. Альтернатива — включить редактор robots.txt в SEO-плагине Rank Math или Yoast и править содержимое прямо в админке без кода.
Как добавить noindex в WordPress без плагина?
Используйте хук wp_robots. В функции-обработчике проверьте нужное условие — например, is_search() или is_paged() — и установите $robots['noindex'] = true вместе с $robots['follow'] = true. WordPress сам добавит корректный метатег в <head> всех подходящих шаблонов, без ручной правки header.php.
Почему страница с noindex всё равно в поиске?
Роботу нужно время: он должен снова посетить страницу и увидеть метатег, и только потом исключает её из индекса. Это не мгновенный процесс — обычно дни или недели. Ускорить можно, переобойдя адрес в панели Яндекс Вебмастера или Google Search Console. Проверьте также, что страница не закрыта в robots.txt — иначе робот её не прочитает.
Что нельзя закрывать в robots.txt?
Нельзя закрывать адреса, которые должны быть в поиске, а также CSS- и JS-файлы темы: без них робот не сможет корректно отрисовать страницу. Не стоит закрывать разделы категорий, изображения и служебные файлы, нужные для рендеринга. Если страница должна передавать вес по ссылкам или показываться в выдаче — оставьте её открытой для обхода.
Как проверить, что robots.txt настроен правильно?
Откройте https://вашсайт.ру/robots.txt и убедитесь, что файл отдаётся с кодом 200 и отображается как текст. Проверьте важные страницы на отсутствие случайного noindex в исходном коде. Затем посмотрите раздел диагностики в Яндекс Вебмастере и Google Search Console. Для массовой проверки удобно написать небольшой скрипт на JavaScript, который скачает robots.txt и метатеги всех ключевых адресов.
Вывод
robots.txt и noindex — это два разных инструмента, и путать их нельзя. Первый управляет обходом: что роботу скачивать, а что нет. Второй управляет индексацией: что показывать в выдаче, а что спрятать. Простое правило, которое снимает 90% проблем: технический мусор закрывайте в robots.txt, а страницы, которые уже в индексе и не должны там быть, помечайте noindex и держите открытыми для обхода.
В WordPress всё делается кодом или плагином. Фильтр robots_txt даёт полный контроль над файлом, хук wp_robots — над метатегом, а Rank Math и Yoast закрывают обе задачи без единой строки сниппета. Главное — не создавать противоречивых сигналов, не закрывать CSS и JS и периодически проверять важные адреса в вебмастере.
Если разбираться с технической оптимизацией и служебными настройками некогда, это можно поручить команде, которая делает сайты на WordPress под ключ: мы настраиваем robots.txt, метатеги, карту сайта и перелинковку, следим за индексацией и сопровождаем проект после запуска. Посмотрите услуги разработки и продвижения, изучите портфолио выполненных проектов и почитайте блог о сайтах и продвижении. Обсудить задачу и получить смету можно через форму контактов — подберём решение под ваш проект и бюджет.